Tin doanh nghiệp
Đăng ngày
Xử lý tài liệu nhiều ngôn ngữ trong Knowledge AI
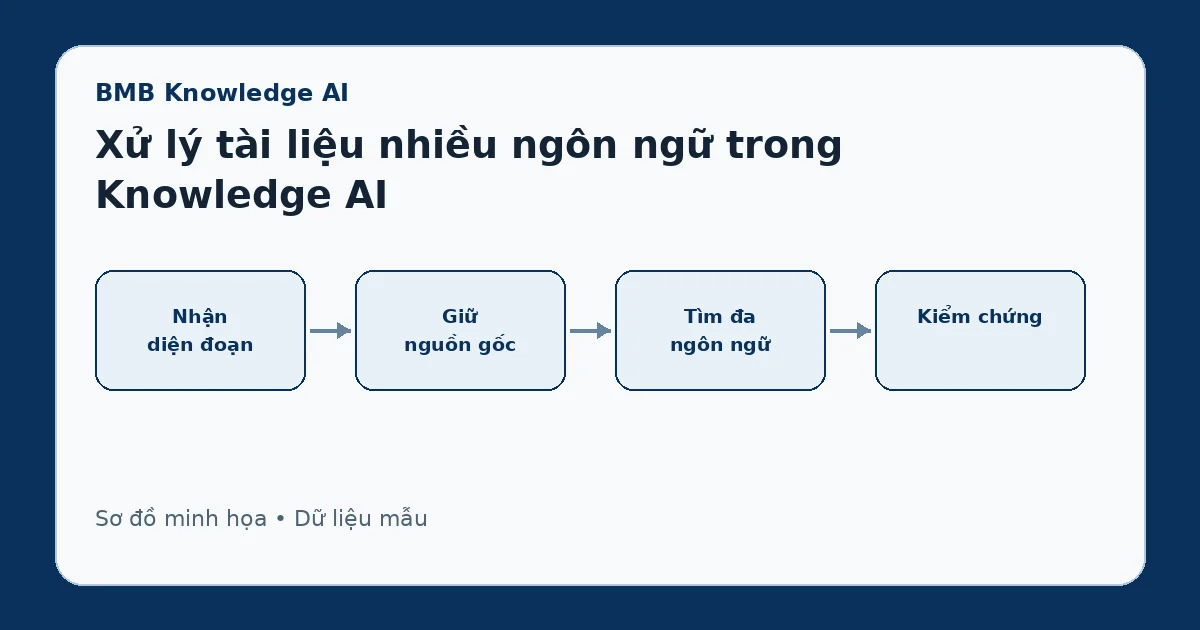
Knowledge AI nên giữ nguyên ngôn ngữ gốc làm bằng chứng, đồng thời tạo lớp hỗ trợ tìm kiếm và diễn giải đa ngôn ngữ có thể truy vết. Dịch toàn bộ tài liệu rồi chỉ lập chỉ mục bản dịch dễ làm mất thuật ngữ, số liệu và phạm vi pháp lý; chỉ giữ bản gốc lại khiến người dùng khó tìm khi câu hỏi dùng ngôn ngữ khác. Cách an toàn là nhận diện ngôn ngữ theo đoạn, bảo toàn cấu trúc, quản lý bản dịch như dữ liệu dẫn xuất và luôn cho người đọc mở đúng đoạn nguồn.
Tình huống nghiệp vụ
Một doanh nghiệp có hợp đồng mua sắm bằng tiếng Anh, hướng dẫn vận hành bằng tiếng Việt và phụ lục kỹ thuật xen tiếng Nhật. Người dùng hỏi bằng tiếng Việt: “Thời gian phản hồi sự cố mức nghiêm trọng cao là bao lâu?”. Hợp đồng ghi “four business hours”, còn hướng dẫn nội bộ dịch thành “bốn giờ” nhưng bỏ từ “làm việc”. Nếu hệ thống ưu tiên bản dịch vì từ khóa gần hơn, câu trả lời có thể sai điều kiện quan trọng.
Nhận diện ngôn ngữ theo cấu trúc
Đơn vị phân loại nên là đoạn văn, ô bảng, chú thích hoặc tiêu đề, không chỉ là toàn tài liệu. Một đoạn quá ngắn như mã thiết bị, tên riêng hoặc số điều khoản có thể không đủ bằng chứng để xác định; khi đó nên kế thừa ngôn ngữ của vùng bao quanh và gắn mức tin cậy. Các đoạn chứa hai ngôn ngữ cần giữ cả hai nhãn hoặc tách theo ranh giới hợp lý.
Trước khi nhận diện, hệ thống phải bảo toàn thứ tự trang, tiêu đề, hàng cột và quan hệ chú thích. OCR nên dùng mô hình phù hợp với bộ ký tự; nếu một trang có tiếng Việt và Nhật, chạy một cấu hình đơn ngữ có thể biến ký tự thành chuỗi rác nhưng vẫn tạo văn bản có vẻ hợp lệ. Đo chất lượng OCR theo từng ngôn ngữ giúp tránh kết luận toàn tệp đạt chỉ vì phần tiếng Việt dễ đọc.
Chiến lược lập chỉ mục
Mỗi đoạn nguồn cần có văn bản gốc, ngôn ngữ, mã tài liệu, phiên bản, vị trí, quyền truy cập và checksum. Lớp tìm kiếm có thể bổ sung bản dịch, từ đồng nghĩa và biểu diễn đa ngôn ngữ, nhưng các trường dẫn xuất phải trỏ về đoạn gốc. Khi câu hỏi tiếng Việt truy xuất một đoạn tiếng Anh, câu trả lời nên hiển thị phần diễn giải tiếng Việt và cho mở nguyên văn tiếng Anh.
Quản lý thuật ngữ và bản dịch
Danh mục thuật ngữ phải có khái niệm chuẩn, biến thể theo ngôn ngữ, đơn vị sở hữu và bối cảnh. “Business day” không nên mặc định dịch thành “ngày” nếu hợp đồng quy định lịch làm việc riêng. Tên sản phẩm, chức danh và mã quy trình có thể được yêu cầu giữ nguyên. Khi thuật ngữ thay đổi, hệ thống cần biết những bản dịch và chỉ mục nào phải làm mới.
Bản dịch máy nên được coi là nội dung hỗ trợ, không thay thế tài liệu chính thức. Với điều khoản có giá trị pháp lý hoặc kỹ thuật cao, nên có bản dịch được phê duyệt hoặc chuyển chuyên gia. Metadata cần chỉ rõ ai dịch, công cụ hay quy trình nào, thời điểm, phiên bản và trạng thái phê duyệt. Câu trả lời phải nói rõ khi đang diễn giải từ bản gốc khác ngôn ngữ.
Quy trình trả lời đa ngôn ngữ
Đầu tiên, xác định ngôn ngữ câu hỏi và giữ nguyên các thuật ngữ, mã, tên riêng. Tiếp theo, tạo tập truy vấn tương đương có kiểm soát dựa trên từ điển của tổ chức. Sau đó tìm trên cả bản gốc lẫn lớp dẫn xuất, hợp nhất kết quả theo mã đoạn và loại bỏ trùng. Bộ kiểm tra chọn phiên bản có hiệu lực, xác nhận quyền và đánh giá liệu đoạn nguồn có trực tiếp hỗ trợ từng mệnh đề.
Khi tạo câu trả lời, hệ thống dùng ngôn ngữ người hỏi nhưng không làm biến mất điều kiện trong nguồn. Thuật ngữ quan trọng có thể ghi kèm nguyên ngữ lần đầu. Trích dẫn phải dẫn đến đúng trang hoặc vùng bảng. Nếu hai bản ngôn ngữ đều được công bố nhưng không thống nhất, hệ thống không tự chọn bản có lợi; cần báo mâu thuẫn và nêu quy tắc ưu tiên nếu tài liệu chính thức đã quy định.
Ngoại lệ thường gặp
Tài liệu song ngữ có hai cột đôi khi bị OCR đọc nối dòng trái sang dòng phải, làm câu vô nghĩa. Bảng phải được phân vùng theo cột ngôn ngữ trước khi trích xuất. Tệp scan có chữ ký, con dấu hoặc ghi chú viết tay cần đánh dấu vùng chưa đọc được. Công thức, mã nguồn và tên trường dữ liệu không nên dịch vì có thể phá khả năng đối chiếu.
Tiêu chí kiểm tra
Bộ thử nên bao gồm văn bản đơn ngữ, song ngữ hai cột, đoạn trộn ngôn ngữ, thuật ngữ không được dịch, số và đơn vị, phủ định, ngày làm việc, bảng, OCR nhiễu và hai bản ngôn ngữ mâu thuẫn. Chuyên gia bản ngữ gắn nhãn câu trả lời và đoạn bằng chứng. Chỉ số cần đo gồm độ chính xác nhận diện, tỷ lệ truy xuất đúng đoạn, bảo toàn thuật ngữ, độ phủ trích dẫn và tỷ lệ sai điều kiện sau dịch.
Trong một phép thử mẫu 200 câu, không nên chỉ báo tỷ lệ tìm đúng chung. Cần tách theo cặp ngôn ngữ và loại cấu trúc. Nếu 190 câu tiếng Anh–Việt đạt nhưng 10 câu trong bảng tiếng Nhật đều sai, điểm 95% sẽ che một khoảng trống nghiêm trọng. Nghiệm thu chỉ hoàn tất khi các nhóm rủi ro chính đều đạt ngưỡng đã thống nhất.
Câu hỏi thường gặp
Có cần dịch trước toàn bộ kho tài liệu không?
Không nhất thiết. Có thể dịch theo nhu cầu hoặc tạo lớp tìm kiếm đa ngôn ngữ, miễn là độ trễ phù hợp và luôn truy vết về nguồn.
Nên trích dẫn bản gốc hay bản dịch?
Nên trích dẫn bản gốc có thẩm quyền; bản dịch giúp người đọc hiểu và phải được gắn trạng thái rõ ràng.
Hệ thống có tự giải quyết hai bản dịch mâu thuẫn không?
Không nên tự kết luận nếu chưa có quy tắc ưu tiên. Hệ thống cần nêu khác biệt và chuyển người phụ trách khi ảnh hưởng quyết định.