Tin doanh nghiệp
Đăng ngày
Kiểm thử bộ câu hỏi trước khi cập nhật Knowledge AI
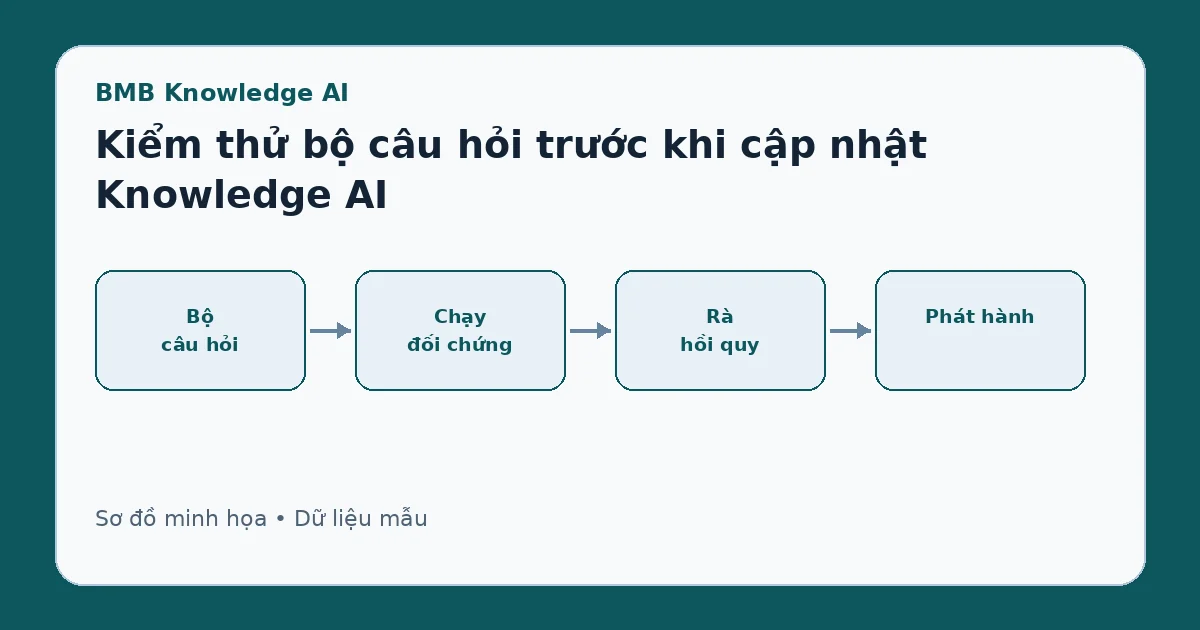
Trước mỗi lần cập nhật mô hình, chỉ mục, bộ kết nối hoặc quy tắc trả lời, Knowledge AI cần chạy lại một bộ câu hỏi đại diện có đáp án và bằng chứng đã được thẩm định. Mục tiêu không phải chứng minh phiên bản mới “thông minh hơn” bằng vài ví dụ đẹp, mà phát hiện hồi quy: trả lời sai phiên bản, mất điều kiện, trích dẫn nhầm, lộ nội dung ngoài quyền hoặc từ chối quá mức. Chỉ nên phát hành khi các tiêu chí rủi ro đạt ngưỡng và sai lệch đã được giải thích.
Tình huống nghiệp vụ
Một đơn vị thay mô hình biểu diễn để cải thiện tìm kiếm câu hỏi dài. Trên 300 câu thử mẫu, tỷ lệ tìm đúng tài liệu tăng từ 86% lên 91%. Tuy nhiên, 12 câu hỏi về thời hạn lại lấy quy định cũ vì mô hình mới ưu tiên đoạn có cách diễn đạt gần hơn và xem nhẹ ngày hiệu lực. Nếu đội dự án chỉ nhìn điểm trung bình, bản cập nhật sẽ được coi là thành công dù một nhóm nghiệp vụ rủi ro bị giảm chất lượng.
Trong ví dụ này, 300 câu, 86%, 91% và 12 lỗi là dữ liệu minh họa. Chúng không phải số liệu công bố về BMB Knowledge AI hoặc kết quả của khách hàng. Ý nghĩa là mỗi chỉ số tổng hợp phải được phân rã theo ý định, nguồn, quyền và mức hậu quả.
Xây dựng bộ câu hỏi đại diện
Bộ câu hỏi nên xuất phát từ nhật ký đã được ẩn dữ liệu nhạy cảm, phỏng vấn người dùng và danh mục nghiệp vụ. Mỗi câu có ý định, phạm vi, đáp án kỳ vọng, các mệnh đề bắt buộc, đoạn bằng chứng, phiên bản tài liệu, quyền người hỏi và mức rủi ro. Với câu không đủ căn cứ, đáp án đúng có thể là từ chối hoặc yêu cầu làm rõ, chứ không phải một đoạn văn hoàn chỉnh.
Không nên chỉ chọn câu hỏi phổ biến và dễ. Cần có câu mơ hồ, phủ định, nhiều điều kiện, số liệu gần giống, tài liệu trùng tên, bảng, tệp scan, nguồn mâu thuẫn, tài liệu hết hiệu lực và câu hỏi ngoài phạm vi. Một phần bộ thử cố định để so sánh theo thời gian; một phần luân phiên để tránh đội phát triển tối ưu riêng cho những câu đã biết.
Tách bộ thử và bảo vệ đáp án
Bộ phát triển giúp chỉnh cấu hình, bộ kiểm định dùng để ra quyết định phát hành và bộ giám sát dùng sau triển khai. Người tinh chỉnh không nên nhìn toàn bộ đáp án kiểm định, nếu không kết quả dễ bị thiên lệch. Mọi thay đổi câu hỏi hoặc nhãn phải qua rà soát và có lịch sử phiên bản.
Các lớp đánh giá cần chạy
Lớp truy xuất kiểm tra đúng tài liệu, đúng đoạn, đúng phiên bản và vị trí của bằng chứng trong danh sách kết quả. Lớp trả lời tách từng mệnh đề để đo độ chính xác, đầy đủ và mức hỗ trợ. Lớp trích dẫn kiểm tra liên kết có mở đúng nguồn và đoạn có thực sự chứng minh phát biểu. Lớp an toàn kiểm tra quyền, thông tin nhạy cảm, prompt độc hại trong tài liệu và hành vi khi thiếu bằng chứng.
So sánh phiên bản một cách công bằng
Hai phiên bản phải chạy trên cùng snapshot dữ liệu, quyền, câu hỏi và cấu hình không liên quan. Nên lưu đầy đủ kết quả từng câu thay vì chỉ giữ điểm tổng. Ma trận chuyển đổi cho biết câu nào từ đúng thành sai, sai thành đúng hoặc giữ nguyên. Một cải thiện ở câu rủi ro thấp không tự động bù cho hồi quy ở câu liên quan thẩm quyền, tài chính hay thông tin hạn chế.
Quy trình từ chạy thử đến phát hành
Đầu tiên, ghi rõ thành phần thay đổi và giả thuyết cải thiện. Tiếp theo, tạo môi trường thử với snapshot và chạy kiểm tra kỹ thuật để chắc rằng bộ câu hỏi không lỗi. Sau đó, chạy phiên bản nền và phiên bản ứng viên, chấm theo cùng quy tắc, phân tích hồi quy theo nhóm. Chuyên gia rà soát lỗi nghiêm trọng và xác nhận nguyên nhân.
Nếu đạt, triển khai canary cho một tỷ lệ người dùng hoặc phạm vi tài liệu nhỏ. Theo dõi câu không có đáp án, phản hồi, độ trễ, trích dẫn và vi phạm quyền. Chỉ mở rộng sau thời gian quan sát đã định. Nếu không đạt, quay lại cấu hình cũ, lưu báo cáo và bổ sung trường hợp lỗi vào bộ thử. Việc “sửa nóng” mà không thêm ca hồi quy sẽ khiến lỗi dễ tái diễn.
Ngoại lệ và bẫy đo lường
Câu hỏi có nhiều cách trả lời đúng cần chấm theo mệnh đề và bằng chứng, không so chuỗi ký tự. Câu trả lời ngắn hơn có thể tốt hơn nếu bỏ suy luận không có nguồn. Ngược lại, từ chối mọi câu hỏi sẽ có vẻ an toàn nhưng không hữu ích, vì vậy phải đo cả tỷ lệ từ chối sai và khả năng yêu cầu bổ sung thông tin.
Tiêu chí nghiệm thu bộ kiểm thử
Bộ thử đạt yêu cầu khi bao phủ các ý định quan trọng, có nhãn truy vết được, tái chạy cho kết quả ổn định và chỉ rõ nguyên nhân của từng thất bại. Cần kiểm tra ngẫu nhiên nhãn giữa ít nhất hai người ở nhóm rủi ro cao để phát hiện đáp án mơ hồ. Dashboard phải cho lọc theo nguồn, ngôn ngữ, quyền, rủi ro và loại lỗi.
Biên bản phát hành nên lưu mã phiên bản, snapshot, số câu, ngưỡng, kết quả từng nhóm, lỗi được chấp nhận, người phê duyệt và kế hoạch quay lui. Một phiên bản không đạt vẫn tạo giá trị nếu báo cáo giúp xác định chính xác thành phần cần sửa; không nên điều chỉnh ngưỡng sau khi xem kết quả chỉ để được thông qua.
Câu hỏi thường gặp
Cần bao nhiêu câu hỏi để kiểm thử?
Không có con số chung. Cần đủ để phủ ý định và rủi ro; nhóm hiếm nhưng hậu quả cao vẫn phải có ca thử riêng.
Có thể dùng hoàn toàn chấm điểm tự động không?
Không nên. Tự động phù hợp cho chạy lặp, còn các lỗi điều kiện, thẩm quyền và mâu thuẫn cần chuyên gia kiểm tra theo mẫu.
Khi chỉ cập nhật tài liệu có phải chạy lại không?
Có, ít nhất với câu liên quan tài liệu đó và một bộ kiểm tra hồi quy chung, vì thay đổi chỉ mục có thể ảnh hưởng thứ hạng nguồn khác.